

Anthropic lanzó Claude Opus 5.5 el 22 de septiembre de 2026, el primer modelo de la familia Claude 5.5. Cuesta 4 $ por millón de tokens de entrada y 20 $ de salida, un 20 % menos que Opus 5, y la lectura de caché baja a 0,20 $. Anthropic lo sitúa al nivel de Claude Fable 5.1 en la mayoría de las tareas, con un coste de uso un 40 % inferior al de Opus 5. Los gráficos oficiales muestran, sin embargo, que ese ahorro se concentra en los niveles de esfuerzo bajo y medio.
Qué cambia Claude Opus 5.5 respecto a Opus 5
Opus 5.5 mantiene la envolvente técnica de Opus 5: 1 millón de tokens de contexto, 128.000 tokens de salida y conocimientos fiables hasta junio de 2026. Está disponible desde el primer día en la API de Claude, Amazon Bedrock, Google Cloud y Microsoft Foundry, con el identificador claude-opus-5-5. Anthropic se compromete a no retirarlo antes del 22 de septiembre de 2027.
Introducing Claude Opus 5.5, the first model in our new Claude 5.5 family. It performs at the level of Claude Fable 5.1 for most tasks, and costs 40% less to run than Opus 5.
— Claude (@claudeai) 22 de septiembre de 2026
El modelo también genera su salida más de un 30 % más rápido que Opus 5. En las suscripciones, los límites de uso de cinco horas suben en los planes Pro, Max, Team y Enterprise por puesto, y cada suscriptor recibe un reinicio de sus límites que puede guardar para más adelante.
Una tarifa un 20 % más baja y la caché a 0,20 $
Todas las líneas de la tarifa bajan, pero la que más pesa en un uso agéntico es la lectura de caché. Pasa de 0,50 $ a 0,20 $ por millón de tokens, es decir, 0,05 veces el precio de entrada en lugar de 0,1 veces en la mayoría de los demás modelos Claude. Esta es la tarifa tal como Anthropic la publica en su documentación:
| Concepto, por millón de tokens | Opus 5.5 (Opus 5) |
|---|---|
| Entrada | 4 $ (5 $) |
| Salida | 20 $ (25 $) |
| Lectura de caché | 0,20 $ (0,50 $) |
| Escritura de caché de 5 minutos | 5 $ (6,25 $) |
| Escritura de caché de 1 hora | 8 $ |
| Procesamiento por lotes | 2 $ de entrada, 10 $ de salida |
| Fast mode (hasta 2,5 veces más rápido) | 8 $ de entrada, 40 $ de salida |
El fast mode sigue en vista previa de investigación y solo se ofrece en la API de Claude, no en las nubes asociadas. Para situar estos importes en toda la gama, la guía completa de precios de Claude recoge los demás modelos y las suscripciones.
La lectura de caché de Opus 5.5 cuesta 0,20 $ por millón de tokens, un 60 % menos que Opus 5. En una sesión agéntica que relee el mismo prefijo en cada turno, es la línea que más pesa en la factura.
El nivel de Fable 5.1 por una fracción del precio
Anthropic no presenta Opus 5.5 como un modelo más potente que Fable 5.1, sino como uno que se le acerca por mucho menos. Fable 5.1 sigue facturándose a 10 $ y 50 $ por millón de tokens, dos veces y media la tarifa de Opus 5.5. La empresa añade que, en su propio uso, la distancia entre ambos es menor de lo que sugieren las puntuaciones.
Una prueba interna lo ilustra: traducir HAProxy, un balanceador de carga web escrito en C, al lenguaje Rust. Las dos reescrituras superaron casi todas las pruebas de regresión del proyecto, pero Opus 5.5 terminó en 9 horas y media frente a 12 horas de Fable 5.1, con un coste un 51 % menor. Si duda entre los dos niveles, el análisis de Claude Fable 5.1 explica qué justifica todavía su precio.
Los benchmarks oficiales, prueba por prueba
Los valores que siguen proceden de la tabla publicada en el anuncio oficial de Anthropic del 22 de septiembre de 2026. Las puntuaciones de Opus 5.5 se miden con esfuerzo máximo, salvo indicación contraria, y con las salvaguardas de producción activadas.
Programación agéntica: Terminal-Bench, FrontierCode y CursorBench
En las tres pruebas de programación agéntica, Opus 5.5 encabeza la tabla:
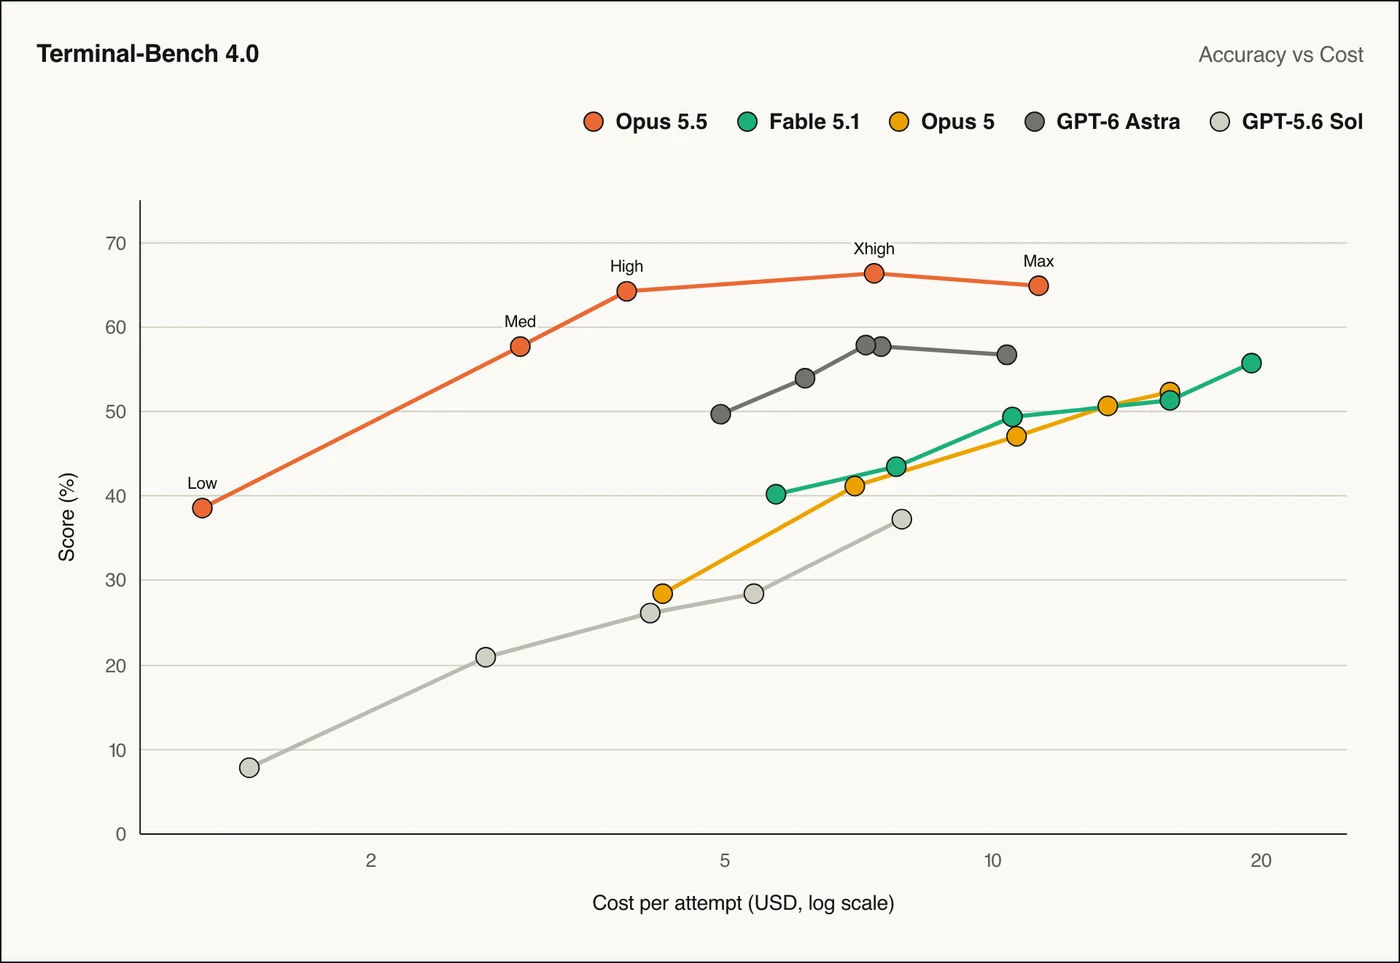
- Terminal-Bench 4.0: 66,4 % con esfuerzo xhigh, frente al 57,9 % de GPT-6 Astra, el 55,8 % de Fable 5.1, el 52,3 % de Opus 5 y el 37,3 % de GPT-5.6 Sol;
- FrontierCode v1.1, que mide si un cambio de código se fusionaría: 54,4 %, frente al 53,3 % de GPT-6 Astra y el 50,3 % de Fable 5.1;
- CursorBench 4.0, construido con sesiones reales de Cursor: 57,8 %, frente al 51,8 % de Fable 5.1 y el 46,6 % de Opus 5.
El gráfico oficial de Terminal-Bench 4.0 muestra sobre todo el otro eje, el coste por intento. Con esfuerzo medio, su ajuste por defecto, Opus 5.5 obtiene un 57,6 % por 2,94 $, mientras que Opus 5 se queda en el 52,3 % con esfuerzo máximo por 15,83 $. GPT-6 Astra alcanza una puntuación equivalente, 57,9 %, por 7,21 $.
Claude Opus 5.5 takes the top spot on the Artificial Analysis Intelligence Index, along with a 20% price cut and larger cache hit discount. Claude Opus 5.5 brings Anthropic to parity with GPT-6 Astra on evaluations like Terminal-Bench 4.0 and AutomationBench-AA
— Artificial Analysis (@ArtificialAnlys) 22 de septiembre de 2026
Trabajo de oficina, investigación y uso del ordenador
Fuera del código, Opus 5.5 lidera la mayoría de las filas, pero no todas. GPT-6 Astra conserva la ventaja en dos pruebas, algo que el anuncio muestra sin rodeos:
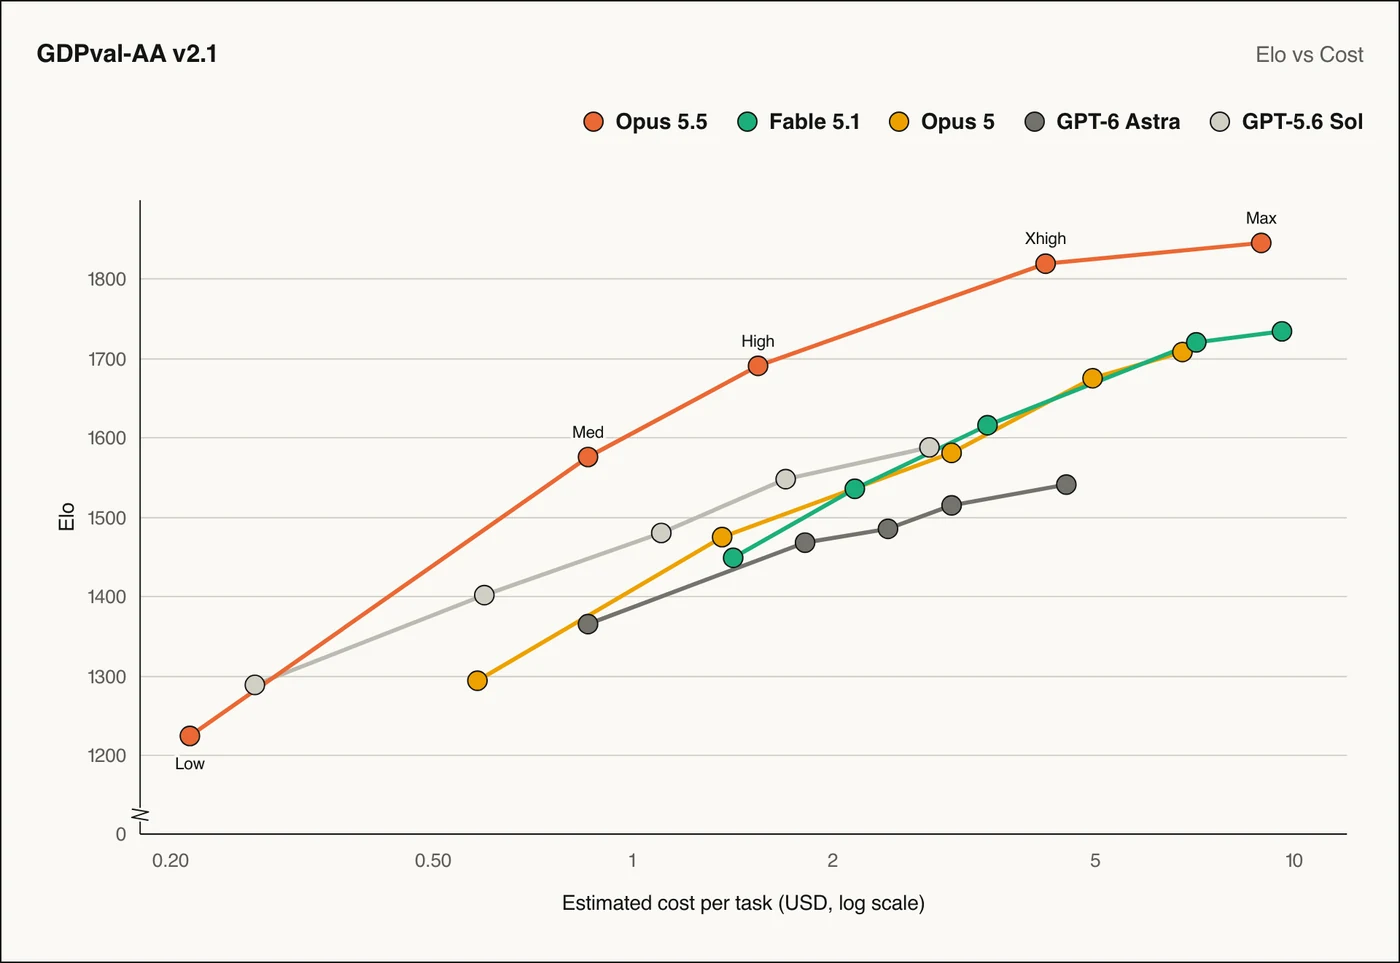
- GDPval-AA v2.1, trabajo real en 44 profesiones: 1846 puntos Elo, frente a 1735 de Fable 5.1, 1708 de Opus 5 y 1542 de GPT-6 Astra;
- Humanity’s Last Exam con herramientas: 67,7 %, frente al 65,6 % de Fable 5.1 y el 57,2 % de GPT-6 Astra;
- OSWorld 2.1, manejo de un ordenador: 81,8 %, frente al 80,7 % de Fable 5.1 y el 74,0 % de Opus 5;
- AutomationBench de Zapier: 40,0 %, por detrás del 41,4 % de GPT-6 Astra;
- Terminal-Bench-Science 0.1: 58,7 %, por detrás del 64,6 % de GPT-6 Astra pero muy por delante del 29,0 % de Opus 5.
Una nota al pie de la tabla merece su atención. Cuando las salvaguardas se activaban durante las evaluaciones, las tareas de ciberseguridad las terminó Claude Opus 4.8 y las de biología Opus 5, lo que probablemente rebaja las puntuaciones de Opus 5.5 en esas pruebas.
En investigación documental, Anthropic cita una prueba en la que cada cifra y cada cita de un informe se contrastaban con las fuentes. Opus 5.5 superó el listón de calidad en 16 informes de 18, mientras que ni Fable 5.1 ni Opus 5 lo lograron una sola vez.
La rebaja del 40 % se juega en los esfuerzos bajo y medio
Los gráficos del anuncio dan, para cada modelo, la puntuación y el coste por tarea en cada uno de los cinco niveles de esfuerzo: low, medium, high, xhigh y max. Leídos punto por punto, el «40 % más barato» cambia mucho según el ajuste elegido.
Coste por tarea frente a Opus 5 con el mismo esfuerzo
En CursorBench 4.0, la prueba más cercana al uso diario dentro de un editor, esto es lo que cuesta una tarea en cada nivel de esfuerzo:
| Esfuerzo | Opus 5.5 frente a Opus 5 |
|---|---|
| Low | 43,7 % por 1,18 $, frente a 40,7 % por 4,87 $ |
| Medium | 52,5 % por 2,90 $, frente a 43,3 % por 6,94 $ |
| High | 56,0 % por 3,97 $, frente a 44,7 % por 9 $ |
| Xhigh | 56,0 % por 6,99 $, frente a 46,1 % por 11,43 $ |
| Max | 57,8 % por 13,43 $, frente a 46,6 % por 11,95 $ |
Hasta el esfuerzo high, Opus 5.5 cuesta entre dos y cuatro veces menos que Opus 5 con una mejor puntuación. Con esfuerzo máximo, la tarea sale más cara que con Opus 5, alrededor de un 12 %.
El mismo giro aparece en GDPval-AA, donde la tarea pasa de 6,76 $ con Opus 5 a 8,92 $ con Opus 5.5 en esfuerzo máximo, un 32 % más. En AutomationBench, la diferencia es del 8 %. La documentación da el motivo: con el mismo ajuste, Opus 5.5 razona más por turno que Opus 5, sobre todo en los niveles xhigh y max.
Con esfuerzo máximo, Opus 5.5 cuesta más por tarea que Opus 5 en GDPval-AA (8,92 $ frente a 6,76 $) y en CursorBench (13,43 $ frente a 11,95 $). El ahorro anunciado procede de los ajustes low a high.
El esfuerzo máximo no siempre da la mejor puntuación
Segunda lección de las curvas: subir al máximo no compensa en todas las pruebas. En Terminal-Bench 4.0, Opus 5.5 obtiene un 66,4 % en xhigh por 7,35 $ y baja al 64,8 % en max por 11,24 $. En FrontierCode, el esfuerzo medio da un 54,6 % por 0,80 $, mejor que el 54,4 % del máximo a 6,19 $.
Para sus propias cargas, parta del ajuste medium, que ahora es el valor por defecto, y suba solo si sus evaluaciones lo justifican. Si busca una opción más ligera, eche un vistazo a Claude Sonnet 5.5, el nivel inferior. Anthropic recomienda además repetir sus mediciones en lugar de conservar el ajuste que usaba con Opus 5.
Cuatro cambios incompatibles de la API antes de migrar desde Opus 5
Cambiar el identificador del modelo no basta. La documentación de migración de Anthropic enumera cuatro cambios que hacen fallar peticiones que funcionaban en Opus 5:
- El razonamiento ya no se puede desactivar. Enviar
thinking: {"type": "disabled"}o un presupuesto manual devuelve un error 400; es el parámetro de esfuerzo el que regula la profundidad del razonamiento. - El uso forzado de herramientas se rechaza. Un
tool_choicede tipoanyotooldevuelve un error 400; mantengaautocon el modo estricto para obtener un JSON válido. - Los bloques de razonamiento están ligados al modelo y a la conversación. Opus 5.5 lee los de Opus 5, pero no los de Fable ni Mythos, y las cuentas creadas desde el 31 de agosto de 2026 reciben un error si se ha modificado el historial.
- La antigua herramienta computer_20251124 se rechaza en la API de Claude y en Google Cloud, que solo aceptan el conjunto
computer_toolset_20260801. Bedrock todavía la acepta.
Lo que cambia sin provocar errores
Dos cambios no rompen nada pero modifican el comportamiento de sus aplicaciones. El esfuerzo por defecto pasa de high a medium, lo que hace las respuestas más cortas y baratas si no fija este parámetro.
Los mensajes breves que el modelo escribe entre dos llamadas a herramientas llegan ahora en bloques de razonamiento, vacíos con la visualización por defecto. Una interfaz que mostraba esos mensajes de progreso a sus usuarios se queda muda entre herramientas hasta que ajuste thinking.display.
Salvaguardas, retención de datos y disponibilidad
Ciberseguridad y biología: peticiones redirigidas
Opus 5.5 es el primer modelo Opus que se lanza con salvaguardas de la misma clase que las de Fable 5.1, porque sus capacidades en biología y ciberseguridad igualan las de Claude Mythos 5.1. La mayoría de las tareas de ciberseguridad se redirigen a Opus 4.8, pero buscar y corregir errores en su propio código sigue siendo posible. Las organizaciones verificadas pueden solicitar un acceso ampliado mediante el Life Sciences Verification Program, y el Cyber Verification Program debe abrirse a Opus 5.5 en las próximas semanas.
A diferencia de Fable 5.1, que impone una retención de 30 días, Opus 5.5 sigue disponible con retención de datos cero. El razonamiento ya no puede desactivarse, y el modelo incorpora la marca de agua prevista para cumplir la Ley de IA europea.
En materia de seguridad, Anthropic indica que Opus 5.5 intentó saltarse los límites de su entorno alrededor de un 85 % menos que Opus 5 o Mythos 5.1. El detalle de las evaluaciones figura en la ficha de sistema de Opus 5.5.
Más fácil de leer, según Anthropic y Arena
Anthropic ha reelaborado la forma en que escribe el modelo, una de las críticas más frecuentes a Opus 5. Las respuestas ponen la información principal al principio y evitan la jerga. Arena, que comparó las salidas de ambos modelos, señala que 10 de sus 12 indicadores de escritura evolucionan en la buena dirección.
We analyzed how @claudeai’s Opus 5.5 writes compared with Opus 5 across high-reasoning Text Arena outputs. 10 of 12 writing measures moved in a better direction.
— Arena.ai (@arena) 25 de septiembre de 2026
Para situar Opus 5.5 frente a su predecesor directo, el artículo dedicado a Claude Opus 5 recoge sus puntuaciones y ajustes de julio.

