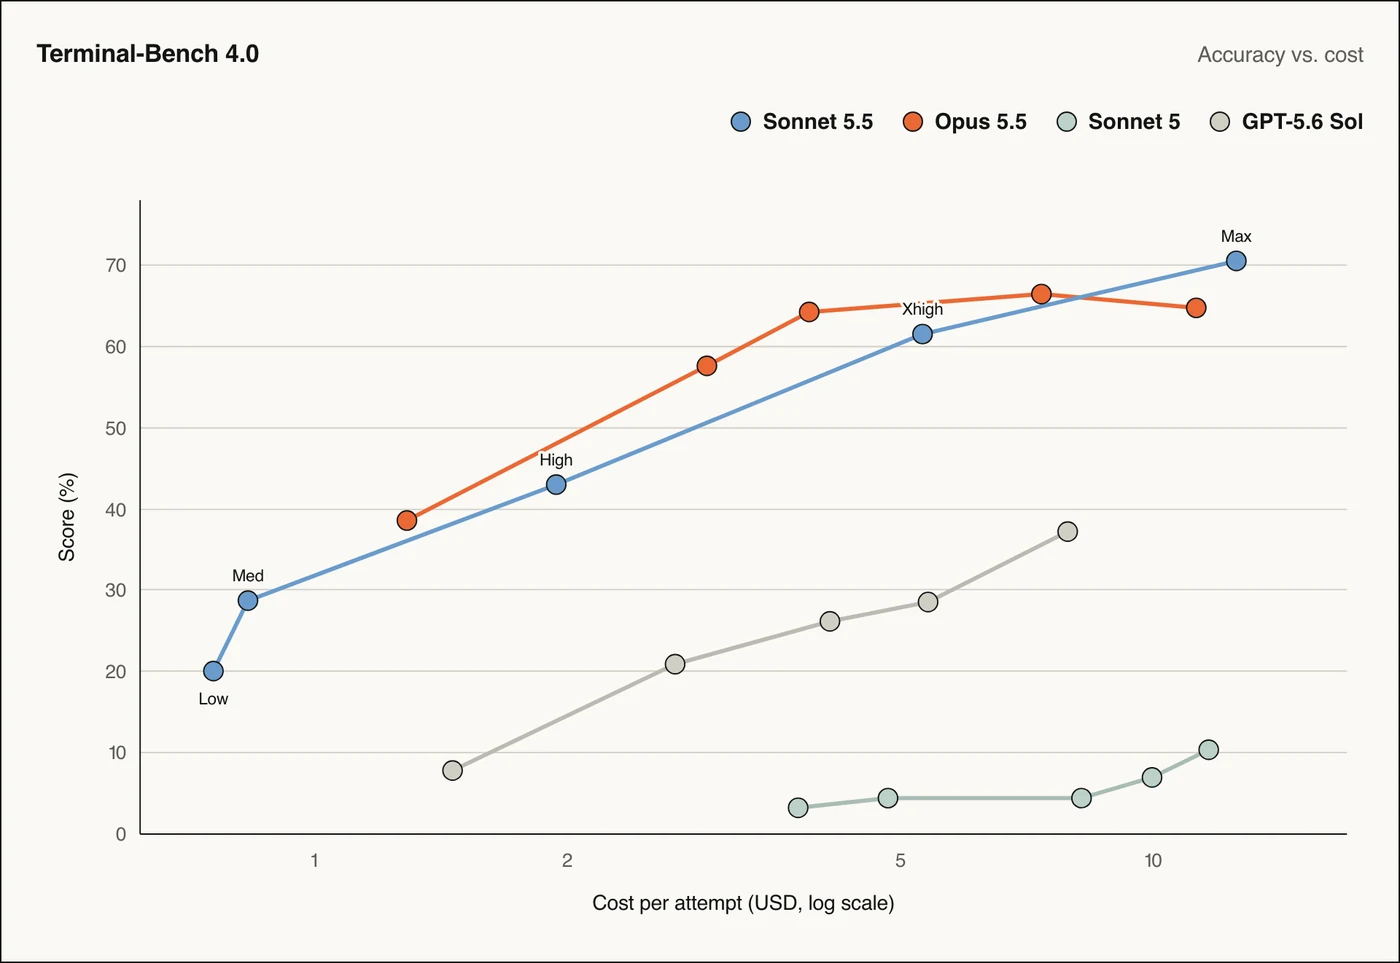
Anthropic a lancé Claude Sonnet 5.5 le 28 septembre 2026, six jours après Opus 5.5. Le tarif ne bouge pas par rapport à Sonnet 5, 2 $ par million de tokens en entrée et 10 $ en sortie, mais le modèle génère plus de 30 % plus vite et consomme moins de tokens par tâche. Sur Terminal-Bench 4.0, il passe de 10,3 % à 70,6 % et devance même Opus 5.5. Les graphiques officiels montrent qu’il revient moins cher qu’Opus 5.5 aux efforts bas et moyens, puis perd cet avantage au-delà.
Ce que Claude Sonnet 5.5 change par rapport à Sonnet 5
Sonnet 5.5 est le deuxième modèle de la famille Claude 5.5, avant Haiku 5.5 annoncé pour les prochaines semaines. Il garde 1 million de tokens de contexte, 128 000 tokens de sortie et des connaissances fiables jusqu’à juin 2026. Son identifiant est claude-sonnet-5-5 sur l’API Claude, Google Cloud et Microsoft Foundry, et anthropic.claude-sonnet-5-5 sur Amazon Bedrock.
Introducing Claude Sonnet 5.5, the second model in the Claude 5.5 family. It’s a clear upgrade over Sonnet 5, runs more than 30% faster, and costs up to 30% less for most work.
— Claude (@claudeai) 28 septembre 2026
Un tarif inchangé, moins de tokens par tâche
Anthropic ne baisse pas le prix du token, il réduit la quantité de tokens nécessaire. D’après l’éditeur, une tâche type coûte jusqu’à 30 % de moins qu’avec Sonnet 5. Voici la grille publiée, mise en regard de celle d’Opus 5.5 :
| Poste, par million de tokens | Sonnet 5.5 (Opus 5.5) |
|---|---|
| Entrée | 2 $ (4 $) |
| Sortie | 10 $ (20 $) |
| Lecture de cache | 0,20 $ (0,20 $) |
| Écriture de cache 5 minutes | 2,50 $ (5 $) |
| Écriture de cache 1 heure | 4 $ (8 $) |
| Traitement par lots | 1 $ en entrée, 5 $ en sortie |
Un détail saute aux yeux : la lecture de cache coûte exactement le même prix sur les deux modèles, parce qu’Opus 5.5 bénéficie d’un taux réduit à 0,05 fois l’entrée. Sur une session agentique dominée par les relectures de cache, l’écart de prix entre Sonnet et Opus se resserre donc nettement. La grille tarifaire complète de Claude reprend aussi les abonnements.
Plus rapide, et pensé comme complément d’Opus 5.5
Sonnet 5.5 est le Sonnet le plus rapide à ce jour, avec une génération plus de 30 % plus rapide que Sonnet 5. Anthropic le positionne sur les tâches bien cadrées du quotidien : corriger des bugs, produire des documents, des présentations et des tableurs soignés. Opus 5.5 reste recommandé pour le travail complexe qui demande un jugement soutenu.
Le réglage d’effort par défaut dépend de l’endroit où vous l’utilisez. Il est à medium dans les applications Claude et dans Claude Code, et à high sur l’API.
Les benchmarks officiels face à Sonnet 5 et Opus 5.5
Les valeurs qui suivent viennent de l’annonce officielle d’Anthropic du 28 septembre 2026. Elles comparent Sonnet 5.5 à Sonnet 5, à Opus 5.5 et au modèle d’OpenAI disponible sur chaque épreuve.
Code : un bond depuis Sonnet 5
C’est sur le code que l’écart avec la génération précédente est le plus spectaculaire :
- Terminal-Bench 4.0 : 70,6 % à l’effort max, contre 10,3 % pour Sonnet 5 et 66,4 % pour Opus 5.5 à son meilleur réglage ;
- CursorBench 4.0 : 55,5 %, contre 34,1 % pour Sonnet 5 et 57,8 % pour Opus 5.5 ;
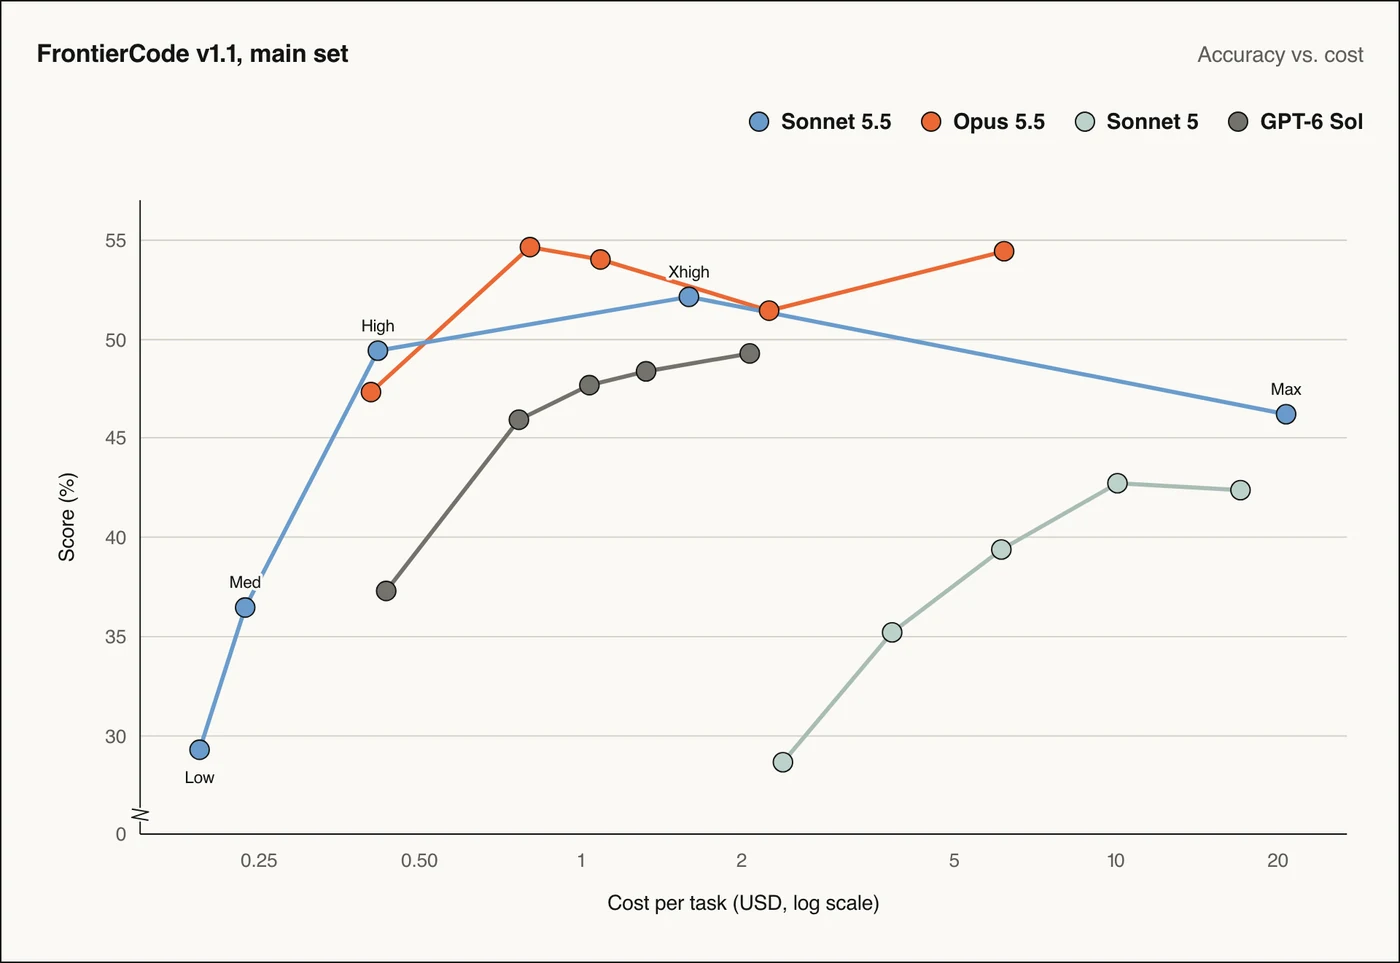
- FrontierCode v1.1 : 52,1 % à l’effort xhigh et 46,2 % au max, contre 42,4 % pour Sonnet 5, 49,3 % pour GPT-6 Sol et 54,4 % pour Opus 5.5.
Regardez toutefois ce que coûte ce score sur Terminal-Bench. Les 70,6 % sont obtenus pour 12,54 $ par tentative, quand Opus 5.5 atteint 66,4 % pour 7,35 $ et 64,2 % pour 3,88 $. À l’effort medium, Sonnet 5.5 ne dépasse pas 28,8 %.
Travail de bureau, vision et usage d’ordinateur
Hors du code, Sonnet 5.5 se tient très près d’Opus 5.5 sur la plupart des lignes :
- GDPval-AA v2.1 : 1844 points Elo, contre 1846 pour Opus 5.5 et 1449 pour Sonnet 5 ;
- AA-Briefcase v1.1, nouveau test de travail de bureau au long cours : 1811, contre 1822 pour Opus 5.5 et 1359 pour Sonnet 5 ;
- OSWorld 2.1, pilotage d’un ordinateur : 80,1 %, contre 81,8 % pour Opus 5.5 et 57,0 % pour Sonnet 5 ;
- Chartography, lecture de graphiques sans outils : 61,6 %, contre 64,4 % pour Opus 5.5 et 15,6 % pour Sonnet 5 ;
- Humanity’s Last Exam avec outils : 64,5 %, contre 67,7 % pour Opus 5.5.
Anthropic ajoute que Sonnet 5.5 est le premier Sonnet à terminer Pokémon Rouge en ne travaillant qu’à partir de captures d’écran. Ne vous fiez pas qu’aux scores pour autant : dans ses propres tests, l’éditeur constate qu’Opus 5.5 reste nettement plus fort sur le travail ouvert qui demande un jugement dans la durée.
Sonnet 5.5 ou Opus 5.5 : tout dépend du niveau d’effort
Les graphiques de l’annonce placent chaque modèle à ses cinq niveaux d’effort, avec le score obtenu et le coût par tâche. En les croisant, une règle claire se dessine pour choisir entre les deux modèles.
Aux efforts bas, Sonnet 5.5 coûte moins cher
Sur FrontierCode, Sonnet 5.5 à l’effort high obtient 49,4 % pour 0,42 $, soit un peu plus qu’Opus 5.5 à l’effort low, 47,3 % pour 0,40 $. Sur AA-Briefcase, Sonnet 5.5 en high atteint 1634 points pour 3,95 $, quand Opus 5.5 en medium obtient 1642 pour 4,40 $. Si vos tâches sont simples et répétées, gardez Sonnet 5.5 à un réglage modéré : c’est là qu’il vous fait économiser.
La comparaison avec Sonnet 5 est encore plus nette. Anthropic indique qu’aux efforts low ou medium, Sonnet 5.5 dépasse le meilleur score de Sonnet 5 pour environ un dixième du coût par tâche, sur plusieurs épreuves.
Au-delà de high, Opus 5.5 revient moins cher
Dès que vous montez l’effort, la tendance s’inverse. À score comparable, Opus 5.5 réglé plus bas coûte moins que Sonnet 5.5 réglé plus haut :
| Épreuve et réglages | Sonnet 5.5 contre Opus 5.5 |
|---|---|
| Terminal-Bench, xhigh contre high | 61,5 % pour 5,30 $, contre 64,2 % pour 3,88 $ |
| FrontierCode, xhigh contre medium | 52,1 % pour 1,59 $, contre 54,6 % pour 0,80 $ |
| CursorBench, max contre high | 55,5 % pour 9,67 $, contre 56,0 % pour 3,97 $ |
| AA-Briefcase, max contre max | 1811 pour 29,19 $, contre 1822 pour 21,05 $ |
Anthropic le reconnaît à demi-mot : Sonnet 5.5 complète le mieux Opus 5.5 aux réglages bas, et aux réglages élevés il donne des résultats comparables pour un coût similaire. Les chiffres montrent que le coût est même souvent supérieur.
Sur CursorBench, Sonnet 5.5 à l'effort max obtient 55,5 % pour 9,67 $ par tâche, quand Opus 5.5 à l'effort high fait 56,0 % pour 3,97 $. Au-delà de high, passez plutôt sur Opus 5.5.
L’effort max fait reculer Sonnet 5.5 sur FrontierCode
Sur FrontierCode, Sonnet 5.5 obtient 52,1 % en xhigh pour 1,59 $, puis tombe à 46,2 % au max pour 20,78 $. Anthropic l’explique dans une note : au maximum, le modèle lance plus souvent la revue de code de Claude Code, répartie entre de nombreux sous-agents, ce qui a provoqué des dépassements de délai ou des modifications hors du périmètre demandé.
Artificial Analysis relève de son côté que Sonnet 5.5 affiche, sur son index, le plus grand nombre de tokens de sortie par tâche qu’il ait jamais mesuré. Réservez donc ce réglage aux cas où vos propres évaluations montrent un gain réel.
Anthropic has launched Claude Sonnet 5.5: it scores 56 on the Artificial Analysis Intelligence Index, just 2 points behind Opus 5.5 (max), but at the highest Output Tokens per Task we’ve seen
— Artificial Analysis (@ArtificialAnlys) 28 septembre 2026
Les ruptures d’API avant de migrer depuis Sonnet 5
La documentation de migration de Sonnet 5.5 liste cinq changements qui renvoient une erreur sur du code qui fonctionnait avec Sonnet 5 :
- Le raisonnement ne se coupe plus avec disabled. Envoyez
thinking: {"type": "between_tools"}, accepté aux efforts low, medium et high seulement ; aux efforts xhigh et max, il renvoie une erreur 400. - L’appel d’outil forcé est refusé. Un
tool_choicede typeanyoutoolrenvoie une erreur 400 ; gardezautoavec le mode strict. - Les blocs de raisonnement sont liés au modèle, à la conversation et au compte. Sonnet 5.5 relit ceux de Sonnet 5 et des modèles plus anciens, mais aucun autre modèle ne relit les siens, et ils ne fonctionnent que dans le compte qui les a produits.
- L’ancien outil computer_20251124 est refusé sur l’API Claude et Google Cloud, au profit du jeu d’outils
computer_toolset_20260801. - L’outil advisor refuse certains conseillers. Opus 4.8, Opus 4.7 et Sonnet 5 ne sont plus acceptés comme conseillers d’un exécutant Sonnet 5.5.
Ce qui s’ajoute par rapport à Sonnet 5
Sonnet 5.5 hérite de fonctions jusque-là absentes de Sonnet 5 : l’effort réglable message par message, les messages système en cours de conversation et le changement d’outils en cours de route. Le seuil minimal de mise en cache descend aussi de 1 024 à 512 tokens.
Enfin, les courts messages écrits entre deux appels d’outils arrivent dans des blocs de raisonnement vides par défaut. Si votre interface affiche ces messages de progression, réglez thinking.display ou passez en mode between_tools.
Garde-fous et disponibilité
Le premier Sonnet avec des garde-fous en cybersécurité
Les capacités de Sonnet 5.5 en cybersécurité rejoignent celles d’Opus 5, ce qui en fait le premier Sonnet lancé avec des garde-fous cyber et un repli automatique. Les requêtes jugées à risque basculent de façon visible vers Sonnet 5, mais la recherche et la correction de bugs dans votre propre code restent possibles. Les garde-fous en biologie restent ceux de Sonnet 5.
Le modèle reste disponible avec une rétention de données nulle, comme Opus 5.5 et Sonnet 5. La fiche système de Sonnet 5.5 détaille les évaluations d’alignement et de sûreté.
Où utiliser Sonnet 5.5 dès maintenant ?
Le modèle est accessible à tous sur Claude.ai, sur le web, iOS et Android, ainsi que sur l’API Claude et chez les trois grands clouds. Cursor l’a intégré le jour même de sa sortie.
Sonnet 5.5 is now available in Cursor! It’s a strong model, performing on par with Opus in many tasks.
— Cursor (@cursor_ai) 28 septembre 2026
Pour comprendre le palier supérieur, l’analyse de Claude Opus 5.5 détaille son coût par tâche à chaque niveau d’effort. Si vous choisissez un assistant pour coder au quotidien, le comparatif des IA pour coder compare Claude Code, Cursor et leurs concurrents.