Anthropic a lancé Claude Opus 5.5 le 22 septembre 2026, premier modèle de la famille Claude 5.5. Il coûte 4 $ par million de tokens en entrée et 20 $ en sortie, soit 20 % de moins qu’Opus 5, et la lecture de cache tombe à 0,20 $. Anthropic le place au niveau de Claude Fable 5.1 sur la plupart des tâches, pour un coût d’usage inférieur de 40 % à celui d’Opus 5. Les graphiques officiels montrent toutefois que cette économie se concentre sur les réglages d’effort bas et moyens.
Ce que Claude Opus 5.5 change par rapport à Opus 5
Opus 5.5 garde l’enveloppe technique d’Opus 5 : 1 million de tokens de contexte, 128 000 tokens de sortie et des connaissances fiables jusqu’à juin 2026. Il est disponible dès le premier jour sur l’API Claude, Amazon Bedrock, Google Cloud et Microsoft Foundry, sous l’identifiant claude-opus-5-5. Anthropic s’engage à ne pas le retirer avant le 22 septembre 2027.
Introducing Claude Opus 5.5, the first model in our new Claude 5.5 family. It performs at the level of Claude Fable 5.1 for most tasks, and costs 40% less to run than Opus 5.
— Claude (@claudeai) 22 septembre 2026
Le modèle génère aussi sa sortie plus de 30 % plus vite qu’Opus 5. Côté abonnements, les limites sur cinq heures augmentent pour les offres Pro, Max, Team et Enterprise facturé par siège, et chaque abonné reçoit une remise à zéro de ses limites qu’il peut garder pour plus tard.
Une grille tarifaire en baisse de 20 %, un cache à 0,20 $
Toutes les lignes de la grille reculent, mais la plus importante pour un usage agentique est la lecture de cache. Elle passe de 0,50 $ à 0,20 $ par million de tokens, soit 0,05 fois le tarif d’entrée au lieu de 0,1 fois sur la plupart des autres modèles Claude. Voici la grille telle qu’Anthropic la publie dans sa documentation :
| Poste, par million de tokens | Opus 5.5 (Opus 5) |
|---|---|
| Entrée | 4 $ (5 $) |
| Sortie | 20 $ (25 $) |
| Lecture de cache | 0,20 $ (0,50 $) |
| Écriture de cache 5 minutes | 5 $ (6,25 $) |
| Écriture de cache 1 heure | 8 $ |
| Traitement par lots | 2 $ en entrée, 10 $ en sortie |
| Fast mode (jusqu’à 2,5 fois plus rapide) | 8 $ en entrée, 40 $ en sortie |
Le fast mode reste en préversion de recherche et n’est proposé que sur l’API Claude, pas chez les clouds partenaires. Pour replacer ces montants dans toute la gamme, la grille tarifaire complète de Claude reprend les autres modèles et les abonnements.
La lecture de cache d'Opus 5.5 coûte 0,20 $ par million de tokens, 60 % de moins qu'Opus 5. Sur une session agentique qui relit le même préfixe à chaque tour, c'est la ligne qui pèse le plus sur la facture.
Au niveau de Fable 5.1 pour une fraction du prix
Anthropic ne présente pas Opus 5.5 comme un modèle plus fort que Fable 5.1, mais comme un modèle qui s’en approche pour bien moins cher. Fable 5.1 reste facturé 10 $ et 50 $ par million de tokens, soit deux fois et demie le tarif d’Opus 5.5. L’éditeur précise que, dans son propre usage, l’écart entre les deux est plus mince que ne le suggèrent les scores.
Un test interne l’illustre : traduire HAProxy, un répartiteur de charge web écrit en C, vers le langage Rust. Les deux réécritures ont passé presque tous les tests de non-régression du projet, mais Opus 5.5 a terminé en 9 h 30 contre 12 heures pour Fable 5.1, pour un coût inférieur de 51 %. Si vous hésitez entre les deux paliers, l’analyse de Claude Fable 5.1 détaille ce qui justifie encore son prix.
Les benchmarks officiels, épreuve par épreuve
Les valeurs qui suivent viennent du tableau publié dans l’annonce officielle d’Anthropic du 22 septembre 2026. Les scores d’Opus 5.5 sont mesurés à l’effort max, sauf mention contraire, et avec les garde-fous de production activés.
Code agentique : Terminal-Bench, FrontierCode et CursorBench
Sur les trois épreuves de code agentique, Opus 5.5 prend la tête du tableau :
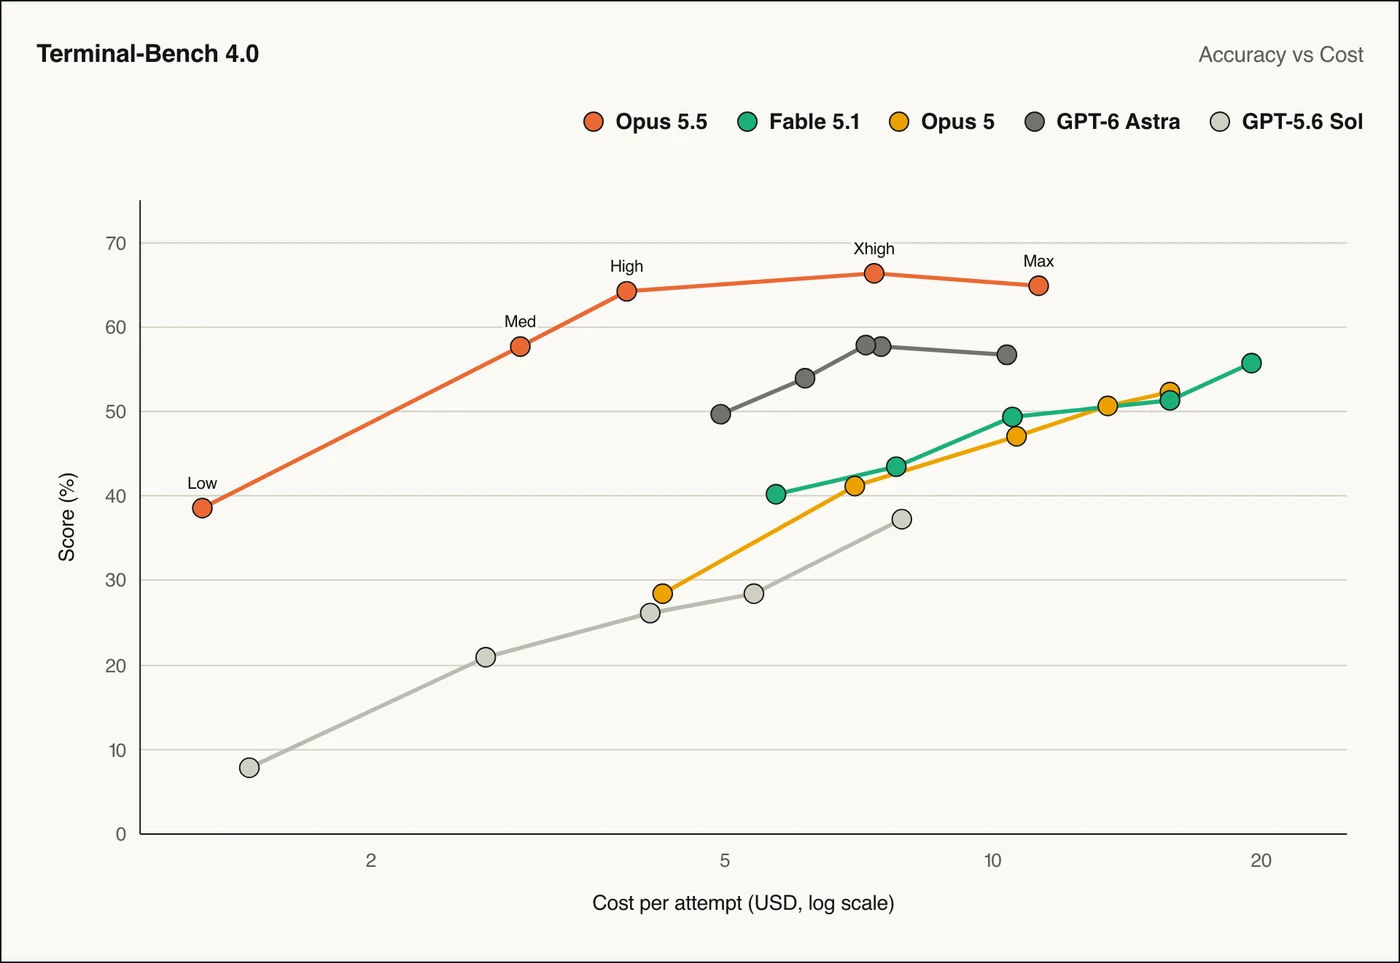
- Terminal-Bench 4.0 : 66,4 % à l’effort xhigh, contre 57,9 % pour GPT-6 Astra, 55,8 % pour Fable 5.1, 52,3 % pour Opus 5 et 37,3 % pour GPT-5.6 Sol ;
- FrontierCode v1.1, qui mesure si une modification de code serait fusionnée : 54,4 %, contre 53,3 % pour GPT-6 Astra et 50,3 % pour Fable 5.1 ;
- CursorBench 4.0, bâti sur de vraies sessions Cursor : 57,8 %, contre 51,8 % pour Fable 5.1 et 46,6 % pour Opus 5.
Le graphique officiel de Terminal-Bench 4.0 montre surtout l’autre axe, le coût par tentative. À l’effort medium, son réglage par défaut, Opus 5.5 obtient 57,6 % pour 2,94 $, quand Opus 5 plafonne à 52,3 % à l’effort max pour 15,83 $. GPT-6 Astra atteint un score équivalent, 57,9 %, pour 7,21 $.
Claude Opus 5.5 takes the top spot on the Artificial Analysis Intelligence Index, along with a 20% price cut and larger cache hit discount. Claude Opus 5.5 brings Anthropic to parity with GPT-6 Astra on evaluations like Terminal-Bench 4.0 and AutomationBench-AA
— Artificial Analysis (@ArtificialAnlys) 22 septembre 2026
Travail de bureau, recherche et usage d’ordinateur
Hors du code, Opus 5.5 mène sur la plupart des lignes, mais pas sur toutes. GPT-6 Astra garde l’avantage sur deux épreuves, ce que l’annonce affiche sans détour :
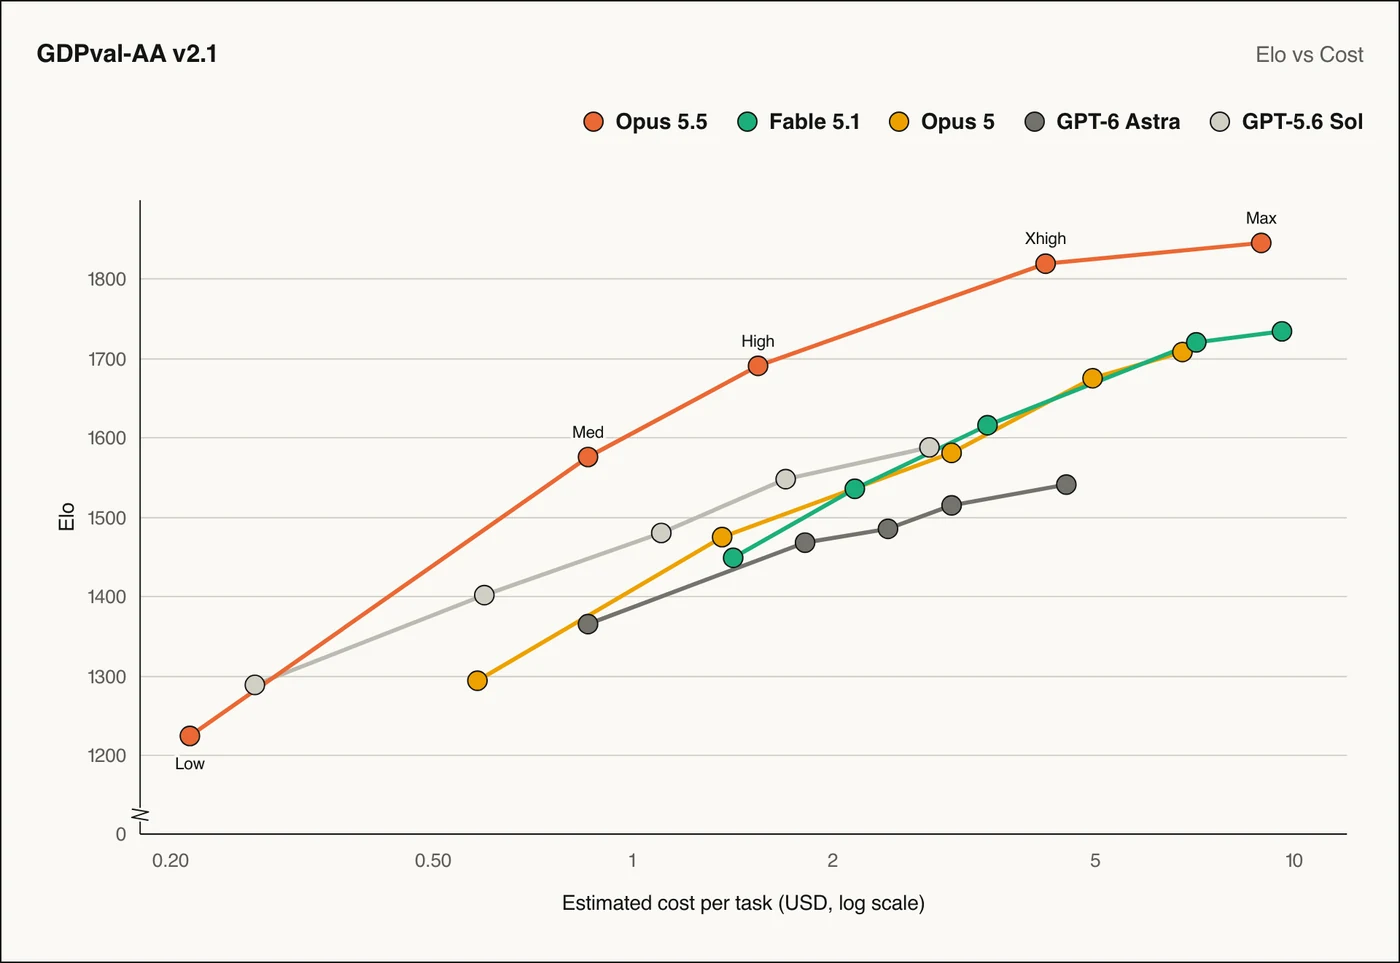
- GDPval-AA v2.1, travail réel sur 44 métiers : 1846 points Elo, contre 1735 pour Fable 5.1, 1708 pour Opus 5 et 1542 pour GPT-6 Astra ;
- Humanity’s Last Exam avec outils : 67,7 %, contre 65,6 % pour Fable 5.1 et 57,2 % pour GPT-6 Astra ;
- OSWorld 2.1, pilotage d’un ordinateur : 81,8 %, contre 80,7 % pour Fable 5.1 et 74,0 % pour Opus 5 ;
- AutomationBench de Zapier : 40,0 %, derrière les 41,4 % de GPT-6 Astra ;
- Terminal-Bench-Science 0.1 : 58,7 %, derrière les 64,6 % de GPT-6 Astra mais loin devant les 29,0 % d’Opus 5.
Une note de bas de tableau mérite votre attention. Quand les garde-fous se déclenchaient pendant les évaluations, les tâches de cybersécurité ont été terminées par Claude Opus 4.8, et celles de biologie par Opus 5, ce qui tire probablement les scores d’Opus 5.5 vers le bas sur ces épreuves.
Sur la recherche documentaire, Anthropic cite un test où chaque chiffre et chaque citation d’un rapport étaient vérifiés contre les sources. Opus 5.5 a franchi la barre de qualité dans 16 rapports sur 18, quand ni Fable 5.1 ni Opus 5 n’y sont parvenus une seule fois.
La baisse de 40 % se joue aux efforts bas et moyens
Les graphiques de l’annonce donnent, pour chaque modèle, le score et le coût par tâche à chacun des cinq niveaux d’effort : low, medium, high, xhigh et max. En les lisant point par point, le « 40 % moins cher » se nuance nettement selon le réglage choisi.
À effort égal, le coût par tâche face à Opus 5
Sur CursorBench 4.0, l’épreuve la plus proche d’un usage quotidien dans un éditeur, voici ce que coûte une tâche à chaque niveau d’effort :
| Effort | Opus 5.5 contre Opus 5 |
|---|---|
| Low | 43,7 % pour 1,18 $, contre 40,7 % pour 4,87 $ |
| Medium | 52,5 % pour 2,90 $, contre 43,3 % pour 6,94 $ |
| High | 56,0 % pour 3,97 $, contre 44,7 % pour 9 $ |
| Xhigh | 56,0 % pour 6,99 $, contre 46,1 % pour 11,43 $ |
| Max | 57,8 % pour 13,43 $, contre 46,6 % pour 11,95 $ |
Jusqu’à l’effort high, Opus 5.5 coûte entre deux et quatre fois moins cher qu’Opus 5 pour un meilleur score. À l’effort max, la tâche devient plus chère qu’avec Opus 5, de 12 % environ.
Le même renversement apparaît sur GDPval-AA, où la tâche passe de 6,76 $ avec Opus 5 à 8,92 $ avec Opus 5.5 à l’effort max, soit 32 % de plus. Sur AutomationBench, l’écart est de 8 %. La documentation en donne la raison : à réglage identique, Opus 5.5 réfléchit davantage par tour qu’Opus 5, surtout aux niveaux xhigh et max.
À l'effort max, Opus 5.5 coûte plus cher par tâche qu'Opus 5 sur GDPval-AA (8,92 $ contre 6,76 $) et sur CursorBench (13,43 $ contre 11,95 $). L'économie annoncée vient des réglages low à high.
L’effort max ne donne pas toujours le meilleur score
Deuxième enseignement des courbes : monter au maximum ne paie pas sur toutes les épreuves. Sur Terminal-Bench 4.0, Opus 5.5 obtient 66,4 % en xhigh pour 7,35 $, puis retombe à 64,8 % en max pour 11,24 $. Sur FrontierCode, l’effort medium donne 54,6 % pour 0,80 $, mieux que les 54,4 % du max à 6,19 $.
Pour vos propres charges, partez du réglage medium, qui est désormais la valeur par défaut, et ne montez que si vos évaluations le justifient. Si vous cherchez une alternative plus légère, regardez du côté de Claude Sonnet 5.5, le palier en dessous. Anthropic recommande d’ailleurs de refaire vos mesures plutôt que de reprendre le réglage utilisé avec Opus 5.
Quatre ruptures d’API avant de migrer depuis Opus 5
Changer l’identifiant de modèle ne suffit pas. La documentation de migration d’Anthropic liste quatre changements qui font échouer des requêtes qui passaient sur Opus 5 :
- Le raisonnement ne se désactive plus. Envoyer
thinking: {"type": "disabled"}ou un budget manuel renvoie une erreur 400 ; c’est le paramètre d’effort qui règle la profondeur de réflexion. - L’appel d’outil forcé est refusé. Un
tool_choicede typeanyoutoolrenvoie une erreur 400 ; gardezautoavec le mode strict pour obtenir un JSON conforme. - Les blocs de raisonnement sont liés au modèle et à la conversation. Opus 5.5 relit ceux d’Opus 5, mais pas ceux de Fable ou de Mythos, et les comptes créés depuis le 31 août 2026 reçoivent une erreur si l’historique a été modifié.
- L’ancien outil computer_20251124 est refusé sur l’API Claude et Google Cloud, qui n’acceptent plus que le jeu d’outils
computer_toolset_20260801. Bedrock l’accepte encore.
Ce qui change sans provoquer d’erreur
Deux évolutions ne cassent rien mais modifient le comportement de vos applications. L’effort par défaut passe de high à medium, ce qui rend les réponses plus courtes et moins chères si vous ne fixez pas ce paramètre.
Les courts messages qu’écrit le modèle entre deux appels d’outils arrivent désormais dans des blocs de raisonnement, vides avec l’affichage par défaut. Une interface qui montrait ces messages de progression à vos utilisateurs devient muette entre deux outils tant que vous ne réglez pas thinking.display.
Garde-fous, rétention et disponibilité
Cybersécurité et biologie : des requêtes redirigées
Opus 5.5 est le premier modèle Opus lancé avec des garde-fous de la même classe que ceux de Fable 5.1, parce que ses capacités en biologie et en cybersécurité rejoignent celles de Claude Mythos 5.1. La plupart des tâches de cybersécurité sont redirigées vers Opus 4.8, mais la recherche et la correction de bugs dans votre propre code restent possibles. Les organisations vérifiées peuvent demander un accès élargi via le Life Sciences Verification Program, et le Cyber Verification Program doit s’ouvrir à Opus 5.5 dans les prochaines semaines.
Contrairement à Fable 5.1, qui impose une rétention de 30 jours, Opus 5.5 reste disponible avec une rétention de données nulle. Le raisonnement ne peut plus être coupé, et le modèle porte le filigrane prévu pour se conformer à l’AI Act européen.
Côté sûreté, Anthropic indique qu’Opus 5.5 a tenté de contourner les limites de son environnement environ 85 % moins souvent qu’Opus 5 ou Mythos 5.1. Le détail des évaluations figure dans la fiche système d’Opus 5.5.
Un modèle plus lisible, selon l’éditeur et Arena
Anthropic a retravaillé la façon dont le modèle écrit, l’un des reproches les plus fréquents faits à Opus 5. Les réponses placent l’information principale en tête et évitent le jargon. Arena, qui a comparé les sorties des deux modèles, relève que 10 de ses 12 indicateurs d’écriture évoluent dans le bon sens.
We analyzed how @claudeai’s Opus 5.5 writes compared with Opus 5 across high-reasoning Text Arena outputs. 10 of 12 writing measures moved in a better direction.
— Arena.ai (@arena) 25 septembre 2026
Pour situer Opus 5.5 face à son prédécesseur direct, l’article consacré à Claude Opus 5 reprend ses scores et ses réglages de juillet. Si vous comparez avec OpenAI, les chiffres de GPT-6 Astra sont analysés avec la même méthode.