

Anthropic lanzó Claude Sonnet 5.5 el 28 de septiembre de 2026, seis días después de Opus 5.5. La tarifa no cambia respecto a Sonnet 5, 2 $ por millón de tokens de entrada y 10 $ de salida, pero el modelo genera más de un 30 % más rápido y consume menos tokens por tarea. En Terminal-Bench 4.0 pasa del 10,3 % al 70,6 % e incluso supera a Opus 5.5. Los gráficos oficiales muestran que sale más barato que Opus 5.5 con esfuerzos bajos y medios, y que pierde esa ventaja por encima.
Qué cambia Claude Sonnet 5.5 respecto a Sonnet 5
Sonnet 5.5 es el segundo modelo de la familia Claude 5.5, antes de Haiku 5.5, anunciado para las próximas semanas. Mantiene 1 millón de tokens de contexto, 128.000 tokens de salida y conocimientos fiables hasta junio de 2026. Su identificador es claude-sonnet-5-5 en la API de Claude, Google Cloud y Microsoft Foundry, y anthropic.claude-sonnet-5-5 en Amazon Bedrock.
Introducing Claude Sonnet 5.5, the second model in the Claude 5.5 family. It’s a clear upgrade over Sonnet 5, runs more than 30% faster, and costs up to 30% less for most work.
— Claude (@claudeai) 28 de septiembre de 2026
La misma tarifa, menos tokens por tarea
Anthropic no baja el precio del token, reduce la cantidad de tokens necesaria. Según la empresa, una tarea típica cuesta hasta un 30 % menos que con Sonnet 5. Esta es la tarifa publicada, frente a la de Opus 5.5:
| Concepto, por millón de tokens | Sonnet 5.5 (Opus 5.5) |
|---|---|
| Entrada | 2 $ (4 $) |
| Salida | 10 $ (20 $) |
| Lectura de caché | 0,20 $ (0,20 $) |
| Escritura de caché de 5 minutos | 2,50 $ (5 $) |
| Escritura de caché de 1 hora | 4 $ (8 $) |
| Procesamiento por lotes | 1 $ de entrada, 5 $ de salida |
Un detalle llama la atención: la lectura de caché cuesta exactamente lo mismo en los dos modelos, porque Opus 5.5 disfruta de una tarifa reducida de 0,05 veces la entrada. En una sesión agéntica dominada por lecturas de caché, la diferencia de precio entre Sonnet y Opus se estrecha mucho. La guía completa de precios de Claude recoge también las suscripciones.
Más rápido y pensado como complemento de Opus 5.5
Sonnet 5.5 es el Sonnet más rápido hasta la fecha, con una generación más de un 30 % más rápida que Sonnet 5. Anthropic lo orienta a tareas cotidianas bien delimitadas: corregir errores y producir documentos, presentaciones y hojas de cálculo cuidadas. Opus 5.5 sigue siendo la recomendación para el trabajo complejo que exige un criterio sostenido.
El ajuste de esfuerzo por defecto depende de dónde lo use. Es medium en las aplicaciones de Claude y en Claude Code, y high en la API.
Los benchmarks oficiales frente a Sonnet 5 y Opus 5.5
Los valores que siguen proceden del anuncio oficial de Anthropic del 28 de septiembre de 2026. Comparan Sonnet 5.5 con Sonnet 5, con Opus 5.5 y con el modelo de OpenAI disponible en cada prueba.
Código: un salto desde Sonnet 5
Es en el código donde la distancia con la generación anterior resulta más llamativa:
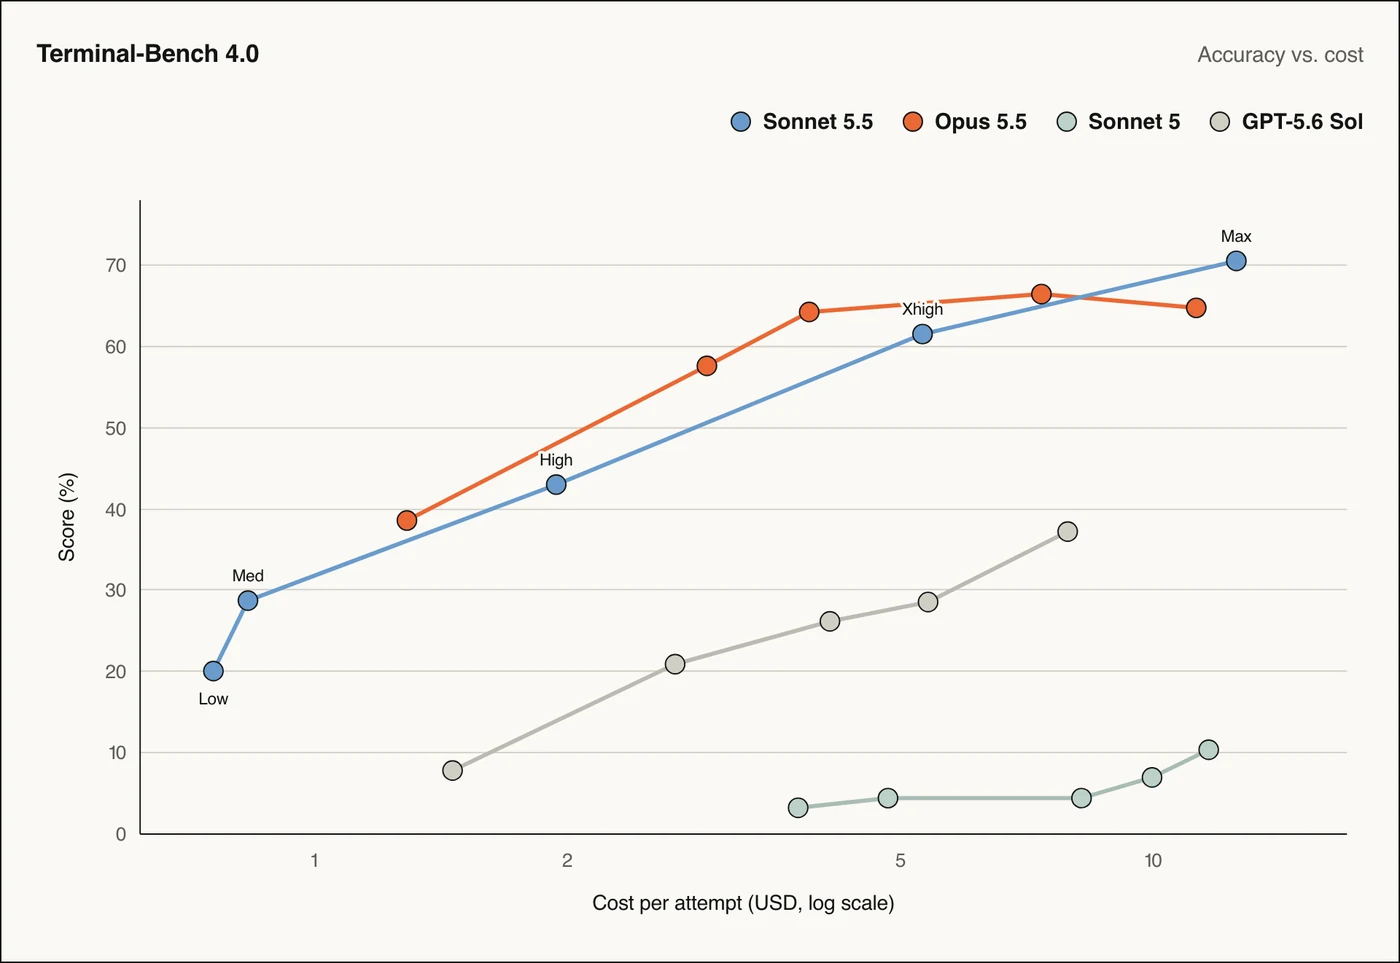
- Terminal-Bench 4.0: 70,6 % con esfuerzo máximo, frente al 10,3 % de Sonnet 5 y el 66,4 % de Opus 5.5 en su mejor ajuste;
- CursorBench 4.0: 55,5 %, frente al 34,1 % de Sonnet 5 y el 57,8 % de Opus 5.5;
- FrontierCode v1.1: 52,1 % con esfuerzo xhigh y 46,2 % en max, frente al 42,4 % de Sonnet 5, el 49,3 % de GPT-6 Sol y el 54,4 % de Opus 5.5.
Fíjese, eso sí, en lo que cuesta esa puntuación en Terminal-Bench. El 70,6 % se obtiene por 12,54 $ por intento, mientras que Opus 5.5 alcanza el 66,4 % por 7,35 $ y el 64,2 % por 3,88 $. Con esfuerzo medio, Sonnet 5.5 no pasa del 28,8 %.
Trabajo de oficina, visión y uso del ordenador
Fuera del código, Sonnet 5.5 se mantiene muy cerca de Opus 5.5 en la mayoría de las filas:
- GDPval-AA v2.1: 1844 puntos Elo, frente a 1846 de Opus 5.5 y 1449 de Sonnet 5;
- AA-Briefcase v1.1, nueva prueba de trabajo de oficina de largo recorrido: 1811, frente a 1822 de Opus 5.5 y 1359 de Sonnet 5;
- OSWorld 2.1, manejo de un ordenador: 80,1 %, frente al 81,8 % de Opus 5.5 y el 57,0 % de Sonnet 5;
- Chartography, lectura de gráficos sin herramientas: 61,6 %, frente al 64,4 % de Opus 5.5 y el 15,6 % de Sonnet 5;
- Humanity’s Last Exam con herramientas: 64,5 %, frente al 67,7 % de Opus 5.5.
Anthropic añade que Sonnet 5.5 es el primer Sonnet que completa Pokémon Rojo trabajando solo a partir de capturas de pantalla. No se fíe solo de las puntuaciones: en sus propias pruebas, la empresa constata que Opus 5.5 sigue siendo claramente superior en el trabajo abierto que exige criterio sostenido.
Sonnet 5.5 u Opus 5.5: todo depende del nivel de esfuerzo
Los gráficos del anuncio sitúan cada modelo en sus cinco niveles de esfuerzo, con la puntuación obtenida y el coste por tarea. Al cruzarlos aparece una regla clara para elegir entre los dos modelos.
Con esfuerzos bajos, Sonnet 5.5 cuesta menos
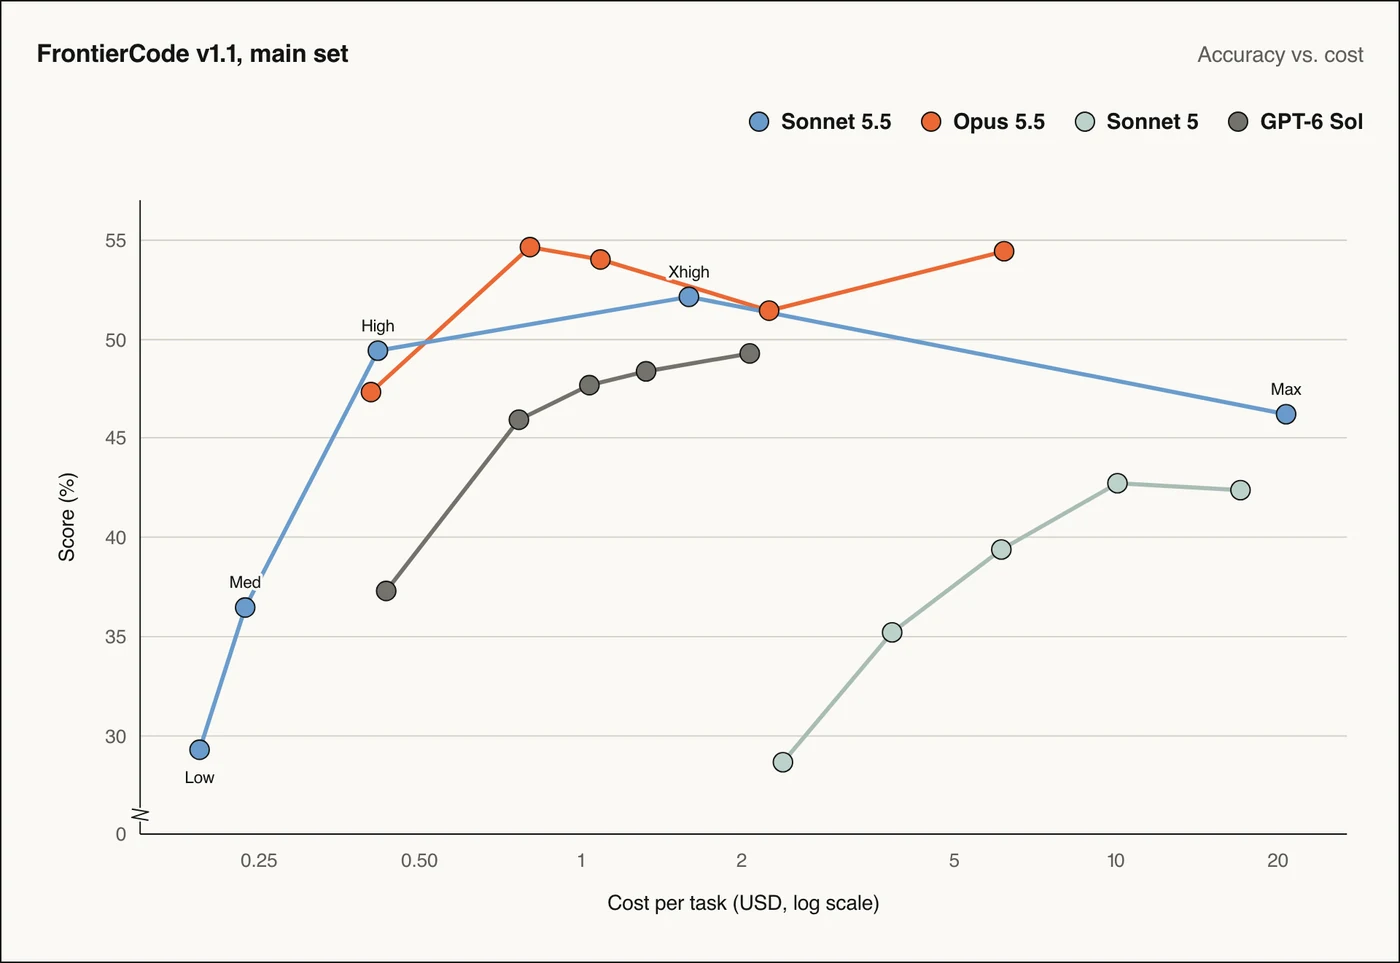
En FrontierCode, Sonnet 5.5 con esfuerzo high obtiene un 49,4 % por 0,42 $, algo más que Opus 5.5 con esfuerzo low, 47,3 % por 0,40 $. En AA-Briefcase, Sonnet 5.5 en high alcanza 1634 puntos por 3,95 $, mientras que Opus 5.5 en medium obtiene 1642 por 4,40 $. Si sus tareas son sencillas y repetitivas, mantenga Sonnet 5.5 en un ajuste moderado: ahí es donde le hace ahorrar.
La comparación con Sonnet 5 es todavía más clara. Anthropic indica que, con esfuerzos low o medium, Sonnet 5.5 supera la mejor puntuación de Sonnet 5 por alrededor de una décima parte del coste por tarea, en varias pruebas.
Por encima de high, Opus 5.5 sale más barato
En cuanto sube el esfuerzo, la tendencia se invierte. Con una puntuación comparable, Opus 5.5 en un ajuste más bajo cuesta menos que Sonnet 5.5 en uno más alto:
| Prueba y ajustes | Sonnet 5.5 frente a Opus 5.5 |
|---|---|
| Terminal-Bench, xhigh frente a high | 61,5 % por 5,30 $, frente a 64,2 % por 3,88 $ |
| FrontierCode, xhigh frente a medium | 52,1 % por 1,59 $, frente a 54,6 % por 0,80 $ |
| CursorBench, max frente a high | 55,5 % por 9,67 $, frente a 56,0 % por 3,97 $ |
| AA-Briefcase, max frente a max | 1811 por 29,19 $, frente a 1822 por 21,05 $ |
Anthropic lo reconoce a medias: Sonnet 5.5 complementa mejor a Opus 5.5 en los ajustes bajos, y en los altos ofrece resultados comparables a un coste similar. Las cifras muestran que el coste suele ser incluso mayor.
En CursorBench, Sonnet 5.5 con esfuerzo máximo obtiene un 55,5 % por 9,67 $ por tarea, mientras que Opus 5.5 con esfuerzo high logra un 56,0 % por 3,97 $. Por encima de high, pase a Opus 5.5.
El esfuerzo máximo hace retroceder a Sonnet 5.5 en FrontierCode
En FrontierCode, Sonnet 5.5 obtiene un 52,1 % en xhigh por 1,59 $ y cae al 46,2 % en max por 20,78 $. Anthropic lo explica en una nota: en el máximo, el modelo lanza con más frecuencia la revisión de código de Claude Code, repartida entre muchos subagentes, lo que provocó tiempos agotados o cambios fuera del alcance de la tarea.
Artificial Analysis señala por su parte que Sonnet 5.5 registra, en su índice, el mayor número de tokens de salida por tarea que ha medido nunca. Reserve ese ajuste para los casos en que sus propias evaluaciones muestren una ganancia real.
Anthropic has launched Claude Sonnet 5.5: it scores 56 on the Artificial Analysis Intelligence Index, just 2 points behind Opus 5.5 (max), but at the highest Output Tokens per Task we’ve seen
— Artificial Analysis (@ArtificialAnlys) 28 de septiembre de 2026
Los cambios incompatibles de la API antes de migrar desde Sonnet 5
La documentación de migración de Sonnet 5.5 enumera cinco cambios que devuelven un error en código que funcionaba con Sonnet 5:
- El razonamiento ya no se desactiva con disabled. Envíe
thinking: {"type": "between_tools"}, aceptado solo con esfuerzos low, medium y high; con xhigh y max devuelve un error 400. - El uso forzado de herramientas se rechaza. Un
tool_choicede tipoanyotooldevuelve un error 400; mantengaautocon el modo estricto. - Los bloques de razonamiento están ligados al modelo, a la conversación y a la cuenta. Sonnet 5.5 lee los de Sonnet 5 y de modelos anteriores, pero ningún otro modelo lee los suyos, y solo funcionan en la cuenta que los produjo.
- La antigua herramienta computer_20251124 se rechaza en la API de Claude y en Google Cloud, en favor del conjunto
computer_toolset_20260801. - La herramienta advisor rechaza algunos asesores. Opus 4.8, Opus 4.7 y Sonnet 5 ya no se aceptan como asesores de un ejecutor Sonnet 5.5.
Lo que añade respecto a Sonnet 5
Sonnet 5.5 incorpora funciones que Sonnet 5 no tenía: el esfuerzo ajustable mensaje a mensaje, los mensajes de sistema a mitad de conversación y el cambio de herramientas sobre la marcha. El mínimo para almacenar en caché también baja de 1.024 a 512 tokens.
Por último, los mensajes breves escritos entre dos llamadas a herramientas llegan en bloques de razonamiento vacíos por defecto. Si su interfaz muestra esos mensajes de progreso, ajuste thinking.display o pase al modo between_tools.
Salvaguardas y disponibilidad
El primer Sonnet con salvaguardas de ciberseguridad
Las capacidades de Sonnet 5.5 en ciberseguridad igualan las de Opus 5, lo que lo convierte en el primer Sonnet lanzado con salvaguardas cibernéticas y un respaldo automático. Las peticiones de mayor riesgo pasan de forma visible a Sonnet 5, pero buscar y corregir errores en su propio código sigue siendo posible. Las salvaguardas de biología siguen siendo las de Sonnet 5.
El modelo sigue disponible con retención de datos cero, como Opus 5.5 y Sonnet 5. La ficha de sistema de Sonnet 5.5 detalla las evaluaciones de alineamiento y seguridad.
¿Dónde usar Sonnet 5.5 desde ya?
El modelo está abierto a todos en Claude.ai, en la web, iOS y Android, así como en la API de Claude y en las tres grandes nubes. Cursor lo integró el mismo día de su lanzamiento.
Sonnet 5.5 is now available in Cursor! It’s a strong model, performing on par with Opus in many tasks.
— Cursor (@cursor_ai) 28 de septiembre de 2026
Para entender el nivel superior, el análisis de Claude Opus 5.5 detalla su coste por tarea en cada nivel de esfuerzo.

